
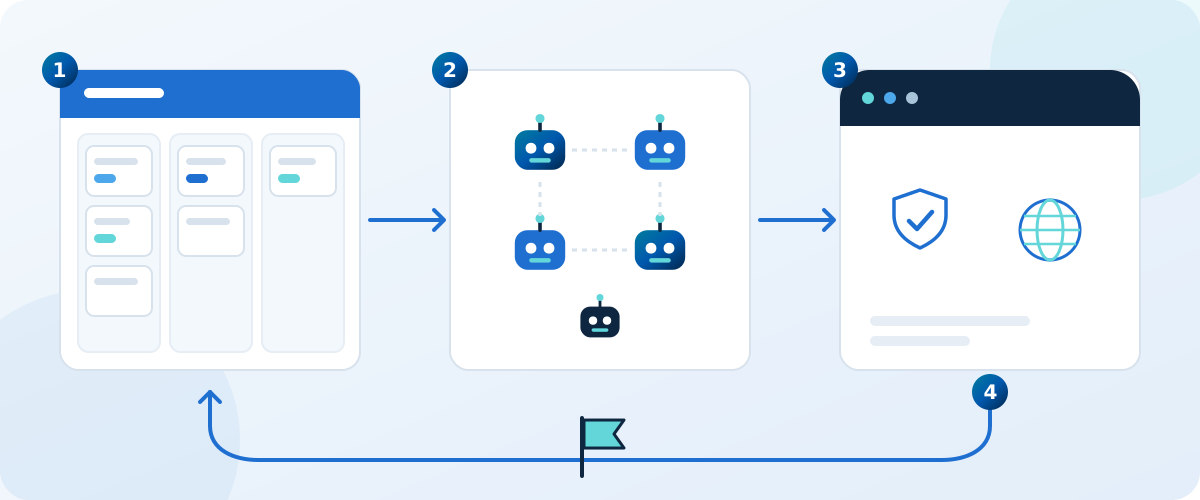
La mayoría de las empresas que venden herramientas de entrega de software construyen su propio producto a la antigua y luego te piden que confíes en la herramienta. Nosotros lo hacemos al revés. El producto de Dutopilot lo construye Dutopilot. Su repositorio está conectado al servicio alojado exactamente como lo estaría el de un cliente. Los tickets están en un tablero del proyecto, y los agentes los planifican, los construyen, los revisan, los prueban, los corrigen y los fusionan. Cada merge a la rama main se despliega en producción.
El propio producto de Dutopilot, desde el 29 de septiembre
Nuestros primeros proyectos de clientes, en la versión actual desde el 19 de agosto
Este artículo explica cómo funciona en la práctica: la configuración, lo que le pasa a un solo ticket, cómo llegan decenas de cambios de personas y agentes cada día a la misma rama main sin hacer cola unos detrás de otros, qué ocurre cuando algo falla y qué siguen haciendo las personas de nuestro lado. También muestra lo que hemos medido y lo que hemos aprendido que puedes aplicar en tu propio equipo.
Una aclaración sobre qué es Dutopilot, para que el resto tenga sentido. Dutopilot es a la vez un servicio gestionado y software como servicio. Es una capa por encima de los agentes de programación: ejecuta Claude Code, Codex, OpenCode y Oh My Pi con tu propia cuenta de IA, en infraestructura en la nube dedicada, y cada cliente cuenta con un Forward Deployed Engineer que lo configura en torno a tu backlog y te acompaña. Cada agente es un miembro virtual del equipo de Dutopilot, y cada uno puede ejecutar cientos de subagentes en paralelo, en todos los planes. Tú conservas el tablero del proyecto que ya usas. Los agentes hacen el trabajo de entrega.
Por qué construir el producto con él mismo
Hay tres razones, y la primera no es marketing.
La primera razón es la honestidad. Una herramienta de entrega que nunca ha llevado el trabajo de su propio creador no se ha probado con el cliente más exigente que existe: uno que cambia de opinión a diario, crea tickets vagos, hace merge con prisa y nota cada minuto lento. Cuando nuestro propio producto espera por una revisión atascada, lo notamos esa misma tarde. Esa presión es mejor batería de pruebas que cualquiera que pudiéramos escribir a propósito.
La segunda razón es la velocidad del feedback. Cuando un agente se detiene, entra en un bucle o produce un cambio que no aceptaríamos, la persona que puede arreglar Dutopilot es la misma que acaba de sufrir el problema. No hay una cola de soporte entre el dolor y la reparación. Un defecto que encontramos se convierte enseguida en un ticket en el tablero, y la corrección sigue por el mismo pipeline.
La tercera razón es una prueba que puedes inspeccionar. Cuando decimos que el proceso aguanta muchos cambios a la vez, describimos nuestro propio repositorio, donde personas y agentes hacen merge en la misma rama main todo el día. No describimos un proyecto de demostración hecho para lucir bien.
Nada de esto significa que cada cliente deba esperar exactamente nuestra configuración. Los clientes eligen sus propias aprobaciones, su propio tablero y sus propios repositorios. Lo que se mantiene es el método: entra un ticket, sale un cambio verificado y fusionado, y una persona interviene solo en las puertas que importan para ti.
Míralo sobre tu propio backlog
Reserva una llamada y un Forward Deployed Engineer te mostrará cómo quedaría esta configuración en uno de tus proyectos. O empieza gratis con el plan Solo.
La configuración: un tablero, un repositorio y un reparto claro del trabajo
La configuración es deliberadamente sencilla, porque un cliente tiene que poder copiarla.
El tablero del proyecto
Todo el trabajo empieza como un ticket en un tablero del proyecto. El tablero es donde las personas dicen lo que quieren: una capacidad nueva, una corrección, un cambio de texto. Un ticket se escribe en lenguaje normal, como le explicarías algo a un colega. No hace falta que sea una especificación. Si falta algo importante, el paso de planificación lo pregunta.
El repositorio
El código del producto vive en un único repositorio, que el servicio alojado de Dutopilot lee y modifica mediante un permiso concedido, igual que haría con un cliente. Nuestro repositorio no tiene ninguna puerta trasera especial. Si un paso funciona para nosotros, funciona por el mismo camino que usaría tu repositorio.
Cada cambio es una pieza de trabajo pequeña e independiente que va directa a la rama main. No mantenemos ramas de integración de larga vida ni un gran cambio de publicación combinado al final. Las piezas más pequeñas implican revisiones más pequeñas, deshacer es más fácil y no se acumula nada porque una pieza tardía bloquee a diez terminadas.
Qué hacen las personas y qué hacen los agentes
El reparto es fácil de decir. Las personas deciden qué merece la pena hacer y dónde una persona debe dar el visto bueno. Los agentes hacen el trabajo de entrega que hay en medio.
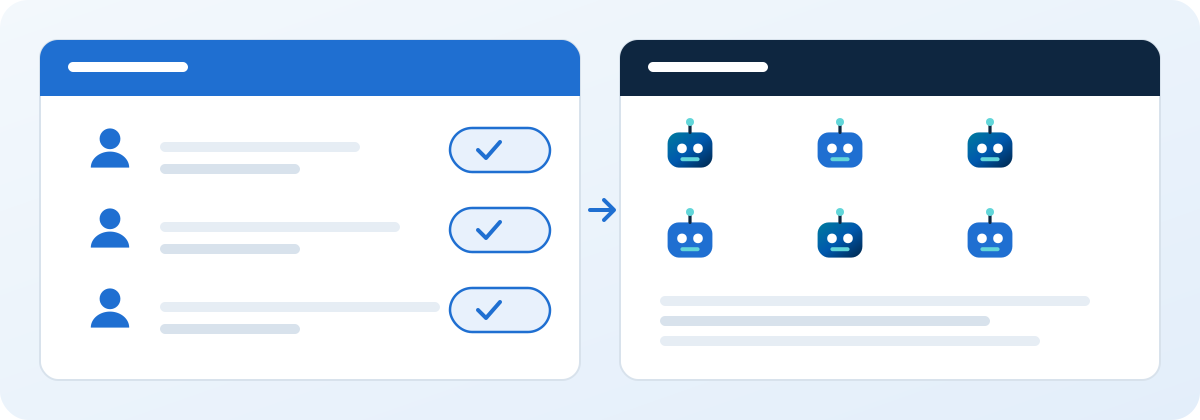
- Personas: escriben y priorizan los tickets en el tablero, responden las preguntas que un agente no pudo resolver solo, aprueban los pasos que eligieron dejar tras una puerta humana y toman las decisiones de producto.
- Agentes: refinan el ticket, lo planifican, lo dividen cuando es grande, escriben el código y las pruebas, revisan el trabajo de los demás, ejecutan las comprobaciones de calidad, reparan fallos, fusionan y despliegan.
Detrás están tus cuentas de IA. Dutopilot ejecuta Claude Code, Codex, OpenCode y Oh My Pi con tu propia suscripción o clave, de modo que el coste del trabajo de IA va a una cuenta que controlas y ves exactamente adónde va. Los agentes de tu plan no comparten un único canal estrecho. Cada agente del plan se comporta como un miembro virtual del equipo de Dutopilot que puede repartir partes de un trabajo entre tantos subagentes en paralelo como necesite.
La vida de un ticket, paso a paso
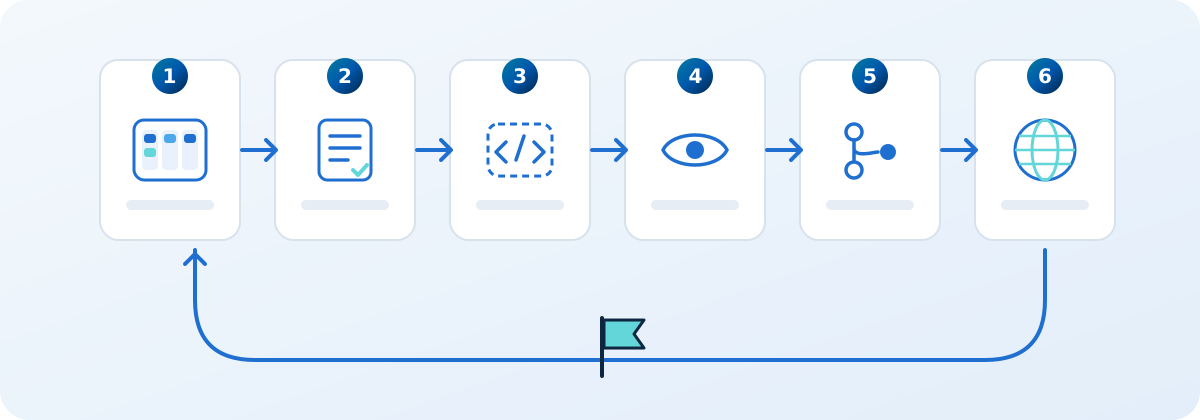
Esto es lo que le pasa a un ticket, desde que está listo hasta que está en producción. Un ticket pasa en total por nueve etapas: arquitecto, planificador, implementador, puerta, tres revisores, autocorrector y QA. Describimos el camino en el orden en que lo verías. Los siete pasos numerados de abajo agrupan esas nueve etapas, y las ocho tarjetas de la imagen muestran el mismo recorrido.
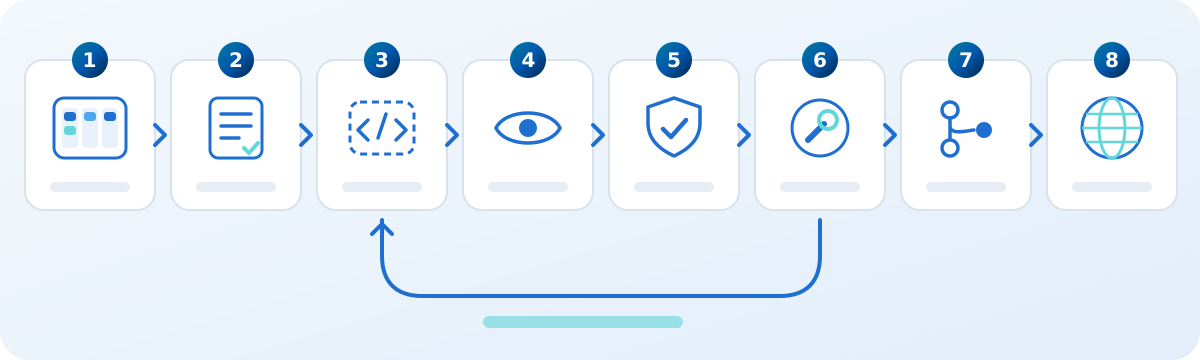
1. Refinamiento y planificación
Cuando un ticket se marca como listo, un agente lo lee junto con las partes del repositorio que toca. Su primera tarea no es escribir código. Su primera tarea es comprobar que el ticket se puede construir: ¿el objetivo está claro?, ¿hay algo contradictorio?, ¿falta una decisión que solo puede tomar una persona?
Si el ticket está claro, un agente arquitecto y un agente planificador lo convierten en un plan: qué cambiar, en qué orden, qué podría salir mal y cómo saber que funcionó. Un ticket grande se divide en tickets más pequeños, cada uno algo que se puede construir, revisar y entregar por separado. La división importa: los tickets pequeños terminan antes y cuesta menos revisarlos, y un problema en uno no frena al resto.
Si falta algo que solo una persona puede decidir, el agente lo pregunta, con palabras sencillas, en el ticket. Basta con una respuesta con las palabras de la propia persona. Nadie tiene que aprender frases especiales.
2. Construcción en un sandbox aislado
La construcción ocurre en infraestructura en la nube dedicada, en un sandbox creado para ese único ticket. El sandbox recibe una copia nueva del repositorio, hace el trabajo y se descarta después. Nada de la ejecución de un ticket puede filtrarse a la de otro.
Dentro del sandbox, un agente de programación (Claude Code, Codex, OpenCode u Oh My Pi, con tu cuenta) escribe el cambio y las pruebas que lo acompañan. Como el trabajo se reparte entre subagentes, uno puede encargarse de los datos mientras otro se ocupa de la pantalla y un tercero escribe las pruebas, todo en el mismo sandbox. Antes de escribir nada, el sandbox fusiona la última versión de la rama main en su copia de trabajo. Volvemos sobre por qué ese momento importa en la sección sobre trabajar a escala.
3. Revisión independiente
Cuando termina la construcción, el cambio se abre como un pull request, que es la forma habitual de proponer un cambio para su revisión. Los revisores son agentes distintos que no escribieron el código. Leen el cambio con ojos nuevos, lo comparan con el ticket y con el plan, y buscan errores, casos olvidados, atajos arriesgados y cambios que se salen de lo que pedía el ticket.
Separar al revisor del autor tiene el mismo sentido que con las personas. Un autor lee lo que quiso escribir. Un revisor lee lo que realmente hay.
4. Puertas de calidad
Junto con la revisión se ejecutan varias puertas de calidad. Una puerta es una comprobación automática con un resultado claro de aprobado o suspendido: las pruebas, las comprobaciones de tipos y de estilo, una verificación de que el cambio toca lo que el plan decía que tocaría, y controles de aspectos como la seguridad y el aspecto de las páginas.
5. El ciclo de autorreparación
Cuando un revisor encuentra un problema o una puerta falla, el ticket no vuelve a una persona. Pasa a una etapa de reparación. Un agente corrector lee el fallo exacto, cambia el código y devuelve el cambio a la revisión y a las puertas. Este ciclo se repite mientras haya progreso. Si el mismo fallo vuelve una y otra vez sin avanzar, se cambia de enfoque en lugar de repetir lo mismo, y si aun así no se puede resolver, el ticket se detiene con una explicación clara que una persona puede atender.
6. Merge
Cuando todas las puertas están en verde y la revisión está limpia, el cambio se fusiona en main. El merge es de tipo squash, así que cada ticket queda como una única entrada limpia en el historial, fácil de leer y fácil de deshacer. Si elegiste mantener una aprobación humana antes del merge, el ticket espera esa aprobación y le dice a la persona exactamente qué está aprobando.
7. Despliegue
En nuestro propio producto, un merge a main es una publicación: el despliegue arranca solo y lleva el cambio a producción. El ticket se cierra solo cuando el trabajo está realmente en vivo y comprobado, no cuando se fusiona el pull request. Si falla una comprobación del despliegue, se trata como cualquier otro fallo: vuelve como trabajo para los agentes, no como un mensaje que espera a que una persona se dé cuenta. En los proyectos de clientes el trabajo se detiene en staging o en pruebas, una persona publica, y el ticket termina ahí.
Un ejemplo práctico (ilustrativo)
Ejemplo ilustrativo. Este es un ticket inventado para mostrar el flujo. No es el registro de un cambio concreto.
El ticket: "Mostrar la próxima fecha de facturación en la página de la cuenta, para que los clientes dejen de preguntar al soporte cuándo les toca el próximo cobro."
Planificación. El agente lee el ticket y el código de la página de la cuenta. Se da cuenta de que el ticket no dice qué mostrar a los clientes con un plan gratuito y hace una pregunta en el ticket. Una persona de producto responde en una frase: no mostrar nada. El arquitecto escribe un plan breve: añadir la fecha a los datos de la cuenta, mostrarla en la página, ocultarla en los planes gratuitos y añadir pruebas para ambos casos. El cambio es lo bastante pequeño para entregarse como un solo ticket.
Construcción. Un sandbox arranca con una copia nueva del repositorio y le fusiona la última versión de main. Un agente de programación añade el campo, un segundo subagente actualiza la página y un tercero escribe las pruebas. Después abre un pull request.
Revisión y puertas. Un agente revisor señala que la fecha se muestra en un único formato fijo, aunque el producto está disponible en cinco idiomas. Una puerta también avisa de que falta una prueba para un cliente cuyo plan se renueva el último día del mes. Ambos hallazgos pasan a la etapa de reparación.
Reparación. Un agente corrector usa el formato de fechas adaptado al idioma que el producto ya tiene y añade la prueba que faltaba. El cambio vuelve a pasar por la revisión y las puertas, y todo queda en verde.
Merge y despliegue. El cambio se fusiona en main, la versión sale y la comprobación sobre la página en vivo pasa. El ticket se cierra. Ninguna persona abrió un editor de código, y la única intervención humana fue una frase en el ticket.
¿Quieres este ciclo en tu tablero del proyecto?
Un Forward Deployed Engineer configura el tablero, el repositorio y las aprobaciones que quieras, y te acompaña mientras los agentes se encargan del trabajo de entrega. Reserva una llamada o empieza gratis con el plan Solo.
Trabajar a escala: muchos tickets, muchas personas, una sola rama main
Un solo ticket avanzando por un proceso limpio es el caso fácil. La prueba de verdad son muchos tickets a la vez mientras las personas también hacen merge en el mismo repositorio.
En nuestro repositorio hay muchos tickets en curso al mismo tiempo, cada uno en su propio sandbox, y nuestras propias personas fusionan sus cambios en main durante todo el día. Cada uno de esos merges cambia cómo es main. Un sistema que solo funciona cuando avanza un cambio cada vez pasaría la mayor parte del tiempo esperando. Cada miembro virtual del equipo de Dutopilot puede ejecutar cientos de subagentes en paralelo, en todos los planes.
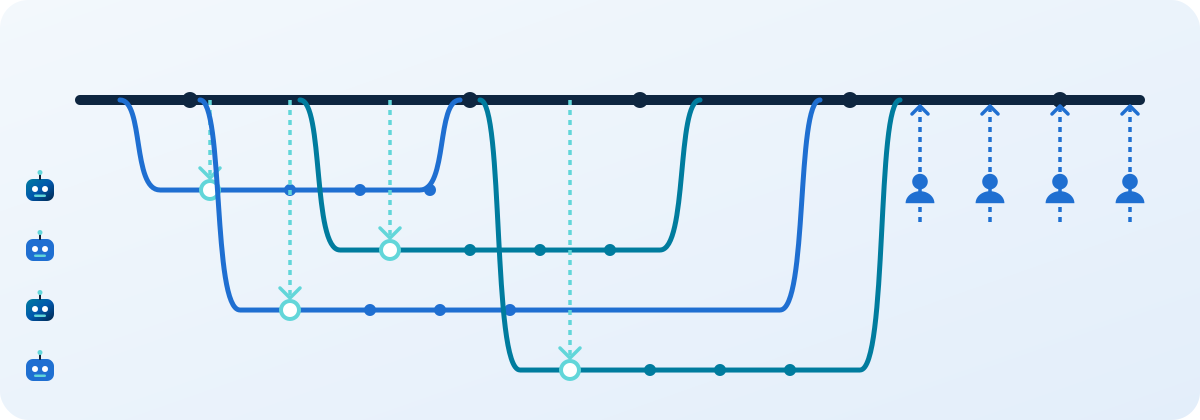
Por qué nada espera a que una rama se ponga al día
Una regla habitual en los equipos de software dice que una rama debe estar al día con main antes de poder fusionarse. Con unas pocas personas es una molestia pequeña. Con decenas de cambios llegando todo el día se convierte en una trampa: en cuanto se fusiona cualquier cambio, todos los demás cambios abiertos vuelven a estar desactualizados y hay que refrescarlos y volver a comprobarlos. Con mucho tráfico ese ciclo no termina nunca, y la gente pasa el día pulsando botones de actualizar.
Rechazamos esa regla a propósito. En su lugar, cada agente fusiona la última versión de main en su propio trabajo justo cuando la necesita: antes de escribir código y otra vez justo antes de las comprobaciones finales. El agente se asegura por sí mismo de que su trabajo es compatible con la main actual, en lugar de esperar a que alguien refresque su rama.
Si main avanzó mientras el trabajo estaba en curso y los dos cambios no se tocan entre sí, no hace falta nada más. Si chocan, el agente resuelve el conflicto en su propia copia, vuelve a ejecutar las comprobaciones y sigue adelante. El coste lo paga el único cambio que realmente chocó, y solo cuando choca. Todos los demás siguen avanzando.
La misma idea vale para cada recurso compartido
Aplicamos la misma prueba a todo lo que comparten varios cambios: el conjunto de sandboxes, el número de solicitudes que podemos enviar al host de código, las cuentas de IA, la cola de trabajo. Las preguntas son siempre las mismas. ¿Esto sigue funcionando con decenas de escritores a la vez? ¿Cada espera termina por sí sola? ¿El coste de cada ciclo crece con la cantidad de trabajo activo, y no con el tamaño de todo el backlog?
Un diseño que es correcto para un ticket cada vez, pero se atasca o necesita a una persona cuando llegan muchos tickets, es para nosotros un diseño equivocado, por muy seguro que parezca. Esa es la primera prueba que debe superar cada decisión sobre nuestro propio producto, y es la razón por la que la configuración aguanta cuando un cliente conecta un repositorio con mucha actividad.
Cuántos tickets puede llevar una cuenta de IA aparece más abajo, en «Las cifras de hoy».
Cuando algo sale mal
En cualquier proceso de entrega algo sale mal. Una prueba que ya era inestable falla, un servicio deja de estar disponible un momento, un agente interpreta mal un ticket, un cambio choca con otro. Lo importante es lo que pasa después, y si una persona tiene que darse cuenta primero.
Primero, la autorreparación
La mayoría de los fallos los gestiona el ciclo de reparación descrito antes. Un agente lee la comprobación fallida, la entiende, la corrige y la vuelve a comprobar. En nuestros primeros proyectos de clientes, los agentes repararon por sí solos 150 fallos de etapa (las cifras están en la sección de cifras). Cada uno de ellos es un momento en el que, en una configuración más tradicional, una persona habría tenido que darse cuenta de una compilación en rojo, averiguar de quién era el problema y perseguir una corrección.
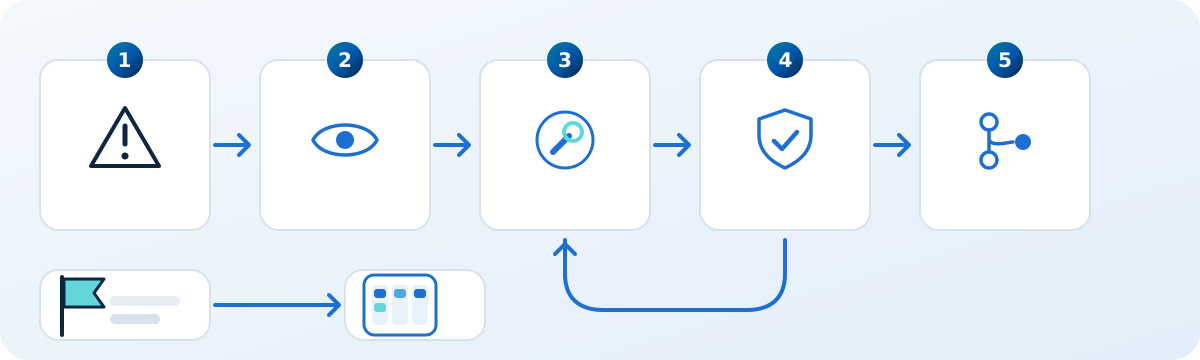
Los defectos que Dutopilot encuentra en sí mismo se convierten en tickets
Dutopilot vigila su propio comportamiento. Cuando detecta un defecto en sí mismo, por ejemplo un ticket que espera sin motivo o un paso que falla siempre de la misma manera, lo comunica como un ticket en su propio tablero del proyecto, con una etiqueta que deja claro que viene del sistema. Ese ticket lo planifican, construyen, revisan y fusionan después los mismos agentes, como cualquier otro. El ciclo del diagrama de arriba es real: lo que ocurre en producción vuelve al tablero y de ahí al siguiente cambio.
Por eso también confiamos en la configuración de nuestro propio repositorio. Un problema no vive en la memoria de alguien ni en un hilo de chat. Es un ticket, con un responsable, un plan y un estado.
Algunos ejemplos reales de defectos que Dutopilot reportó contra sí mismo y luego corrigió. Presentó por su cuenta un informe de que un bucle del planificador se había colgado, y lo corrigió. El panel le dijo una vez a un cliente que arreglara su configuración cuando el fallo era del propio Dutopilot, y lo corrigió para señalar a la parte correcta.
Paradas que una persona puede resolver sola
A veces lo correcto es parar y preguntar. Falta una decisión, una elección tiene consecuencias o una puerta que elegiste necesita a una persona. Cuando Dutopilot se detiene, lo sometemos a un estándar que llamamos autoservicio: quien lea el aviso debe poder resolver la parada por su cuenta, sin documentación y sin nuestra ayuda.
- El mensaje dice con palabras sencillas lo que pasó, antes de cualquier detalle técnico.
- Dice de quién es el problema: su cambio o la configuración.
- Ofrece lo único que la persona puede hacer. Donde hay una opción razonable por defecto, la toma y se lo comunica, con una forma sencilla de deshacerla.
- Funciona una respuesta con las palabras de la propia persona. No hay comandos especiales ni hace falta editar nada a mano.
El detalle técnico (el nombre de la comprobación, el ajuste implicado) va al final, para el administrador. Un aviso que haya que acortar pierde primero el detalle técnico y nunca la explicación clara.
Lo que siguen haciendo las personas
Una automatización que finge que las personas sobran no es creíble, y no es lo que construimos. Las personas siguen haciendo las tres cosas que solo ellas pueden hacer.
- Elegir el trabajo. Qué entra en el tablero, en qué orden y qué no merece la pena hacer. La prioridad es una decisión de negocio. Un agente puede estimar el esfuerzo. No puede saber qué necesita tu mercado este trimestre.
- Aprobar donde elegiste. Tú decides qué pasos quedan tras una puerta humana: un plan, un diseño, un merge, una publicación. Una puerta que eliges es una puerta real. Los agentes esperan en ella y le dicen al aprobador exactamente qué está aprobando. Los pasos que no elegiste los decide Dutopilot cuando tiene confianza, con un registro claro y una forma sencilla de revertirlos.
- Tomar decisiones de producto. Si una funcionalidad existe o no, cómo debe sentirse, qué compromiso aceptar. Los agentes convierten esas decisiones en software que funciona. No sustituyen el criterio que hay detrás.
El efecto es una jornada de trabajo distinta. Las personas dedican su tiempo a decisiones y prioridades. Leen explicaciones breves en lugar de diffs largos. Dejan de vigilar las compilaciones.
Las cifras
Las cifras solo sirven si son concretas sobre lo que cuentan. Damos dos conjuntos separados y no los mezclamos.
En nuestros primeros proyectos de clientes
Estas cifras provienen de nuestros primeros proyectos de clientes. No se midieron en el repositorio de Dutopilot y no las presentamos como si lo fueran. Las cifras de nuestro propio repositorio se miden aparte y aparecen en su propio recuadro más abajo.
Desde junio de 2026
Desde junio de 2026, los agentes han fusionado 127 tickets y completado 539 tareas de agente en nuestros proyectos de clientes. Esos proyectos son serpent.cloud, el sitio web de una empresa de servicios, y un monorepo que combina Salesforce y una app nativa de iOS. Los dos últimos no se nombran aquí. Cada proyecto tiene su propia configuración y sus propias aprobaciones, y en los proyectos de clientes el trabajo se detiene en staging o en pruebas y una persona decide cuándo publicar. Lee las cifras como amplitud, no como el ritmo de un solo proyecto.
En la versión actual, desde el 19 de agosto
Se midió un segundo conjunto, más acotado, en los mismos proyectos de clientes con la versión actual, desde el 19 de agosto:
- 0,4 % de los commits de las ramas de trabajo los escribió una persona. El resto los escribieron los agentes.
- 2 % de los tickets necesitaron una aprobación humana.
- 54 minutos fue la mediana del tiempo desde el primer commit hasta el merge.
- 150 fallos de etapa los repararon los propios agentes.
- 9 etapas componen el camino de un ticket.
El bajo porcentaje de tickets que necesitan una aprobación se debe a cómo configuraron esos proyectos sus aprobaciones. Es un ajuste, no un techo. Si quieres una persona en cada merge, puedes tenerla, y entonces las cifras serán distintas, por elección.
Las cifras de hoy
- Una cuenta de Claude Ultra entrega unos 50 tickets de tamaño medio por semana (unos 25 archivos cada uno), es decir, unos 200 al mes, cuando suficientes miembros virtuales del equipo de Dutopilot trabajan con ella.
- 8 miembros virtuales del equipo de Dutopilot pueden terminar unos 50 tickets en un solo día, lo que consume aproximadamente la cuota semanal de IA de una cuenta.
- Desde el 29 de septiembre, los agentes de Dutopilot han fusionado por su cuenta 497 cambios en el propio producto de Dutopilot, cerrando más de 375 tickets.
- En el plan Solo, el equipo de Dutopilot más pequeño (hasta 3 miembros virtuales) mantiene una cuenta en unos 100 tickets al mes. En el plan Team son unos 200 al mes por cada cuenta de Claude Ultra que conectes.
Mejoramos Dutopilot cada día, así que estas son las cifras de hoy (noviembre de 2026), no un promedio de meses pasados. Las cifras de capacidad son del producto, no mediciones de proyectos de clientes.
Lecciones aprendidas, para tu equipo
Estas son las lecciones de construir de esta manera que sirven a cualquier equipo que quiera confiar el trabajo de entrega a agentes.
Escribe los tickets para un colega capaz
La calidad del resultado depende de la calidad del ticket. Un ticket que indica el objetivo, para quién es y cómo sabrás que funcionó se construye bien. Un ticket que dice "mejorar el panel" recibe primero una pregunta de aclaración. Eso es un buen resultado, y sale más barato que una construcción equivocada.
Mantén cada cambio pequeño
Los tickets pequeños pasan la revisión más rápido, fallan menos y son fáciles de deshacer. Cuando un trabajo es grande, el paso de planificación lo divide. No te resistas a esa división. Un cambio grande es un riesgo que, de otro modo, cargarías durante días.
Deja que agentes distintos revisen
El agente que escribe el código no debería ser el que lo aprueba. Una revisión independiente detecta los errores que el autor no ve, y los hallazgos van directos al ciclo de reparación en lugar de acabar en la mesa de una persona.
Haz que las comprobaciones sean código simple
Todo lo que tenga una respuesta correcta clara, como si una prueba pasó o si un archivo cambió, debe decidirlo software normal, no la opinión de un modelo. Usa los modelos para las tareas de criterio: leer un cambio y decidir si coincide con el ticket.
Diseña desde el primer día para muchos a la vez
Un proceso que es rápido con un ticket y se atasca con diez no es rápido. Prueba cada regla en el caso con mucha carga: sin esperar a que una rama esté al día, sin un recurso compartido que nunca se libera, sin ninguna espera que necesite a una persona para terminar.
Elige tus puertas humanas a propósito
Decide qué pasos necesitan a una persona y haz que esas puertas sean reales. Todo lo demás debería avanzar solo y dejar un registro claro. Una puerta que se elige pero es fácil de saltar enseña a las personas a ignorar las puertas.
Trata cada parada como un mensaje a un cliente
Cada vez que el sistema se detenga, escribe el aviso como si lo fuera a leer alguien que nunca ha oído hablar de la herramienta. Si no puede actuar solo a partir de él, el aviso no está terminado.
Qué significa esto para tu equipo
No necesitas montar una configuración como la nuestra para beneficiarte de ella. La versión práctica es una gestionada.
Conservas tu tablero del proyecto y tus repositorios. Dutopilot se conecta a ellos (Jira, Linear, Notion, GitHub Issues o Azure DevOps para el backlog; GitHub, GitLab, Bitbucket o Azure DevOps para el código; Slack para los avisos), y tu propia cuenta de IA paga el trabajo de IA, así que el coste queda en tus manos. Los agentes se ejecutan en infraestructura en la nube dedicada que gestionamos nosotros, y cada ticket tiene su propio sandbox. Cada miembro virtual del equipo de Dutopilot de tu plan puede orquestar cientos de subagentes en paralelo, en todos los planes. El número de tickets en curso sigue el número de miembros virtuales del equipo de Dutopilot de tu plan (Solo hasta 3, Team hasta 15, Enterprise sin límite) y tus aprobaciones. Los planes se cobran por miembros virtuales del equipo de Dutopilot, no por usuarios: todo tu equipo puede usar Dutopilot.
El Forward Deployed Engineer
Cada cliente cuenta con un Forward Deployed Engineer, un ingeniero de nuestro lado que trabaja contigo y no un servicio de soporte en cuya cola esperas. Conecta tu tablero y tus repositorios, lee tu código y tus convenciones, configura las comprobaciones y aprobaciones que quieras y ajusta los agentes a tu forma de trabajar. También se queda después del lanzamiento: observa cómo fluyen tus primeros tickets, ajusta donde los agentes se atascan y te ayuda a decidir cuándo aflojar o endurecer una puerta.
En la práctica, esto significa que tienes miembros virtuales del equipo de Dutopilot y un ingeniero que sabe hacerlos funcionar en tu código, en lugar de una herramienta que tienes que aprender solo. El mejor primer paso es pequeño: un proyecto, unos pocos tickets y las aprobaciones con las que te sientas cómodo.
Empieza con un proyecto
Reserva una llamada para ver cómo quedaría la configuración en tu repositorio, o empieza gratis con el plan Solo.
Preguntas frecuentes
¿Dutopilot construye de verdad Dutopilot?
Sí. El repositorio del propio producto está conectado al servicio alojado de Dutopilot igual que el de un cliente. Los tickets de su tablero del proyecto los planifican, construyen, revisan, prueban, corrigen y fusionan los agentes, y cada merge a main se despliega en producción.
¿Participan personas en algún momento?
Sí. Las personas eligen el trabajo, aprueban los pasos que decidieron dejar tras una puerta humana y toman las decisiones de producto. Los agentes hacen el trabajo de entrega entre esos puntos.
¿Qué pasa cuando un agente se equivoca?
Lo detecta un revisor o una puerta de calidad, y un agente corrector lo repara y lo devuelve a pasar por las comprobaciones. Si no se puede resolver, el ticket se detiene con una explicación clara que una persona puede atender sin ayuda.
¿Puedo usar la misma configuración en mi propio backlog?
Sí. Conservas tu tablero del proyecto y tus repositorios, y Dutopilot ejecuta Claude Code, Codex, OpenCode y Oh My Pi con tu propia cuenta de IA. Un Forward Deployed Engineer lo configura en torno a tu backlog y a las aprobaciones que quieras.
¿Cómo se integran muchos tickets y muchas personas en una sola rama main?
Cada agente fusiona la última versión de main en su propio trabajo justo cuando la necesita, en lugar de esperar a que refresquen su rama. Así ningún cambio espera a otro y un repositorio con mucho movimiento sigue avanzando.